AI歌声音色クローン
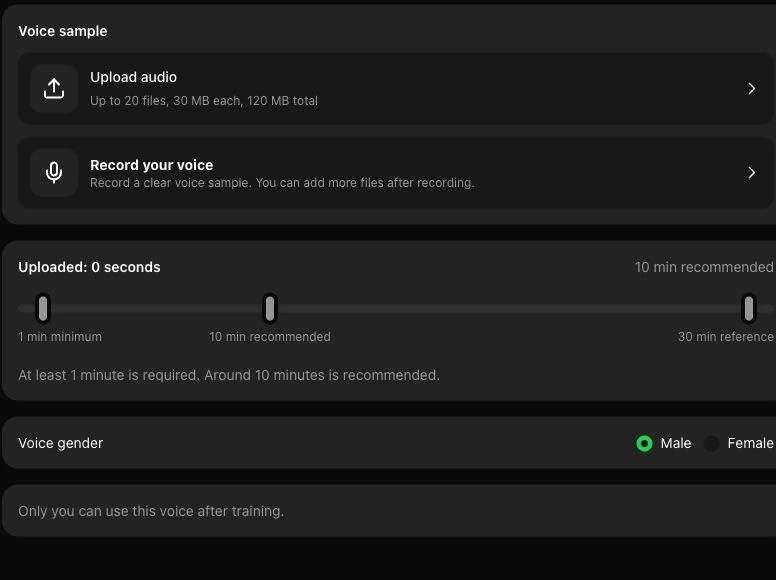
音声サンプル
手元の音声を追加するかブラウザーで録音し、1つずつ聴いてから学習に進めます。送信には10クレジットが必要です。完成したモデルは自分のアカウントで選択でき、別の楽曲カバー作成に使えます。 いくつもの録音から声の特徴を伝えるには、どの音声を使うか決める必要があります。この画面ではサンプルをまとめ、再生してから学習タスクに送れます。
短いテイクをまとめて使えますか?
はい。最大20ファイルを同じタスクに追加できます。各ファイルを聴き、使わないテイクだけを削除できます。合計サイズは120 MB以内にしてください。
音声が十分か、送信前に確認できますか?
画面に読み取り可能な音声の合計時間が表示されます。学習には最低60秒が必要で、目安は約10分です。長さを確認してから10クレジットのタスクを送信できます。
雑音や別のテイクが混ざっていたら?
リスト内で各サンプルを再生し、不要なものを外してください。明瞭で一貫した素材を選ぶのがよい出発点ですが、プレビューで完成モデルの音質を予測することはできません。
モデルが完成したら、どこで使いますか?
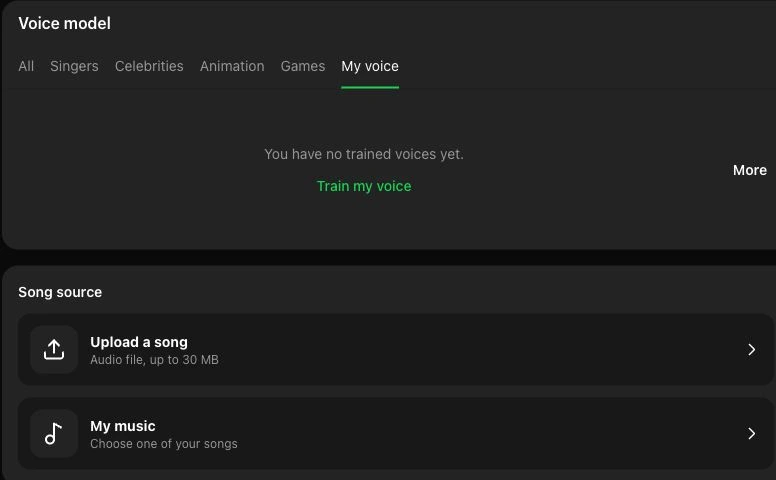
進行状況と完成したモデルは「自分の音声」に表示されます。そのモデルを選べるのは自分のアカウントだけです。完成後は別の楽曲カバー画面で声として選択できます。
選んだ録音からモデルを一度学習すれば、完成後に別のカバーでも同じ声を選べます。曲を変えるたびに同じ音声を集め直す必要はありません。
送信前に声の名前を付けます。完成後の一覧や楽曲カバーで、どの録音を使ったモデルか探しやすくなります。
学習したモデルは共有テンプレートとして他人の一覧に公開されません。自分の声の選択肢として、後から戻って使えます。
ファイル数と容量、再生できる音声、合計時間、10クレジットの学習費用を確認し、不要な素材を外してから送信できます。
モデルが準備できたら、既存の曲を使う楽曲カバーで選択します。カバー作成は曲と2クレジットを必要とする別のタスクです。
音声を用意し、送信する内容を聴いて確かめてから学習を開始します。
音声をアップロードするかブラウザーで録音します。両方を合わせて最大20ファイル、1ファイル30 MB、全体で120 MBまで追加できます。後で分かる名前も付けてください。
各テイクを再生して不要なものを削除し、読み取り可能な合計時間を確認します。最低60秒が必要で、約10分が推奨です。この再生は学習後の声の試聴ではありません。
選んだ音声を10クレジットで送信します。「自分の音声」で準備、学習、完了の状態を追い、完成したモデルを別の楽曲カバーで選びます。
いずれも自分が利用できる録音を用意する場面です。完成後の音の良し悪しを約束する例ではありません。
自分の歌のテイクをまとめて名前を付けておきます。新しい曲の下書きができたとき、同じ声を選んでカバーとして聴き、歌の方向性を考えられます。
一度準備したモデルを別々の楽曲カバータスクで使い、複数のデモに同じ歌声の雰囲気が合うか検討できます。曲ごとに処理は別です。
自分の練習録音を聴き直してからモデルにします。曲の原音と後のカバーを創作上の比較として使い、歌唱力の採点とは区別できます。
録音の組み合わせごとに分かる名前を付け、自分専用の一覧で管理します。次の曲を考えるとき、合う声の案に戻れます。
素材、費用、非公開の範囲と、学習後の使い方を説明します。
使用できる録音を集め、再生と合計時間を確認してから送信してください。学習が完了すると「自分の音声」にモデルが表示されます。