AI 歌声音色克隆
效果示例
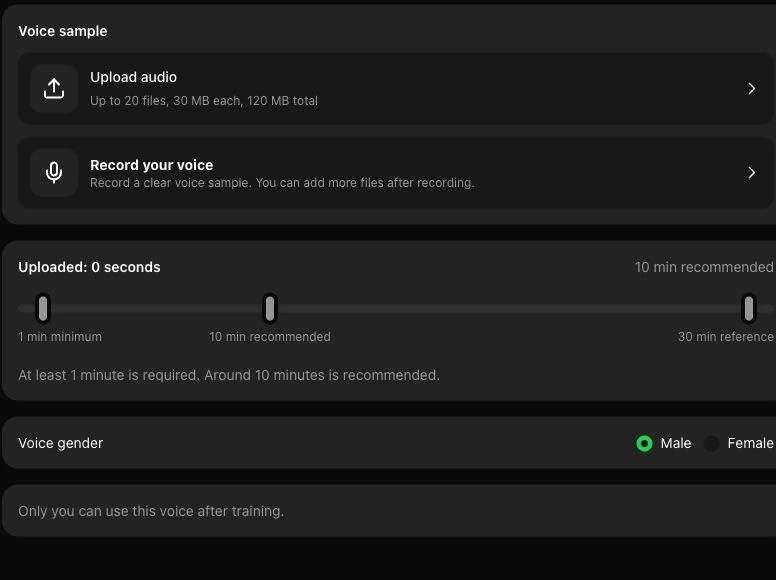
选择你要用于训练的歌声录音:上传音频,或直接在浏览器录制。逐段试听并确认样本后,用 10 积分提交训练。完成的音色模型仅供你的账号选择,也可用于歌曲音色翻唱。 歌声音色模型以你提交的音频为基础。先集中整理、试听和筛选录音,再开始训练,能让每次提交都有明确的声音目标。
声音散落在多个文件里,该选哪些?
把多段录音添加到同一训练任务,逐段试听;不适合的片段可在扣积分前移除。每次最多添加 20 个文件,合计不超过 120 MB,不必只凭文件名猜测内容。
怎么知道准备的音频够不够?
工具会显示可读取音频的累计时长。至少需要 60 秒,建议准备约 10 分钟。你可以在提交前看到是否达到最低要求,而不是提交后才发现片段不足。
如果某段录音不对,或有背景杂音怎么办?
在页面中播放每段样本,替换或移除不想用于训练的录音。清晰、风格较一致的片段通常更适合作为输入,但样本试听不能预言最终模型的效果。
提交后在哪里找到这个音色?
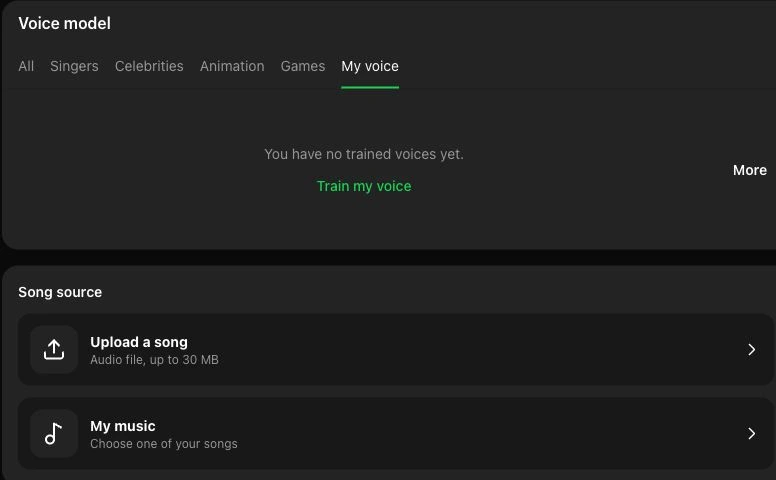
任务会经历处理状态;完成后,模型出现在“我的音色”中。它属于你的账号,可供之后的翻唱任务选择,不会成为供所有人使用的社区模板。
训练会把你选定的录音转成账号下可选择的歌声音色。以后测试不同歌曲时,可以再次使用这个模型,无须为每首歌重复整理相同的训练素材。
训练前给模型起名,之后在音色列表和翻唱音色选择器里都能辨认它。名称可用歌手、录制方式或项目来区分,不必依赖原始文件名。
你训练的模型只归你的账号使用,不会自动开放给其他用户。“我的音色”会显示任务进度,并在训练完成后展示模型。
页面会显示文件数量、大小限制、累计时长以及 10 积分训练费用。在做出扣费决定前,你仍能试听和调整样本。
音色准备好后,可在翻唱工具中与系统模板一样供你选择。训练只创建音色;每次翻唱仍需另选歌曲,并作为独立任务计费。
先检查训练素材,再提交任务,并在“我的音色”中查看处理进度。
上传现有音频、在浏览器录音,也可以混合使用。最多添加 20 个文件,单个不超过 30 MB,合计不超过 120 MB。给音色起一个日后容易认出的名字。
逐段播放并移除不需要的片段,查看页面显示的累计时长。可读取音频至少需要 60 秒,建议约 10 分钟。这里试听的是原始素材,不是训练完成后的模型。
用 10 积分提交选定样本,在“我的音色”查看人声提取、数据准备、训练及完成状态。模型就绪后,可从账号的音色列表中将它用于歌曲翻唱。
训练素材与完成后的模型分开呈现:你能检查将要提交什么,也能知道以后去哪里选择这个声音。
当你现在有可用的声音录音,之后又想用它尝试不同歌曲时,专属模型便于反复选择。以下是使用情境,并非实际生成结果或效果保证。
从自己的演唱中挑选清晰片段,训练并命名音色。新歌草稿准备好后,选择这个模型生成翻唱,听听熟悉的声音与草稿是否匹配。
准备一次相对一致的样本集,之后在不同歌曲或 Demo 版本中选择同一个音色。每次翻唱仍是独立任务,便于按歌曲比较。
收集自己的练习录音,训练前先回听,再用模型尝试正在学习的歌曲。原曲与翻唱的比较适合创意试听,不应当作演唱水平评分。
为不同录制项目取清楚的模型名称,在私人音色列表查看状态。等到出现合适的歌曲想法时,再取用相应音色,不必翻找不知内容的旧录音。
关于样本限制、隐私、积分和训练后用途的具体说明。
从你有权使用的录音开始,检查样本试听与累计时长。确认素材合适后提交训练;完成的专属音色会显示在“我的音色”中。